
Вы купили и настроили пул резидентных прокси с ротацией для парсинга. Однако по логам всё так же видно, что парсер испытывает сложности с работой. Какие-то запросы отклоняются с ошибкой 403, какие-то упираются в капчу. Но хуже всего те, что возвращают код 200 с пустой страницей, не содержащей никаких данных. Эти страницы остаются в вашем датасете долгое время, пока аналитик не увидит наличие аномалии.
IP-адрес — это лишь один из, возможно, сорока различных сигналов, который влияет на работоспособность вашего парсера. В этой статье мы разберём остальные из них, на которые следует обратить внимание, перед тем как писать в техподдержку провайдера прокси.
Мнение эксперта Facebook Store: «Резидентный прокси решает только один уровень — сетевой. Если IP из Огайо, часовой пояс UTC, TLS-отпечаток библиотеки Go, а User-Agent заявляет Chrome на Windows 11, скоринговая система видит не пользователя, а набор противоречий. Именно поэтому мы всегда собираем профиль целиком: IP, гео, язык, часовой пояс, cookies, историю активности и поведенческие паттерны».
Симптом, знакомый каждому — блокировка парсинга на чистых IP-адресах
На небольших объёмах парсер отрабатывает отлично. Но стоит только перейти к масштабированию, как он начинает падать по одному из трёх сценариев.
Первый — ошибка 403 или 429; это самый «честный» вариант. Сервер прямо уведомляет вас о блокировке.
Второй — капча, промежуточная страница или страница проверки. Работа останавливается, поскольку ваш headless-клиент не способен её пройти.
Третий, который обходится дороже всего в плане потерянного времени — это код 200. Тело ответа выглядит как обычный HTML. Количество спарсенных строк примерно соответствует среднестатистическому показателю. Однако сайт отдаёт обрезанный шаблон или фейковую страницу, поэтому данные либо отсутствуют, либо представляют собой мусор. Логика ретраев не срабатывает, так как технически всё прошло без ошибок.
Использовать стратегию «просто ротируй IP-адреса агрессивнее» в качестве метода отладки абсолютно неэффективно именно из-за третьего сценария. Вы меняете только одну переменную, в то время как целевой сервер оценивает два десятка других, а ответ 200 никогда не вызывает повторного запроса.
На что смотрят антибот-системы
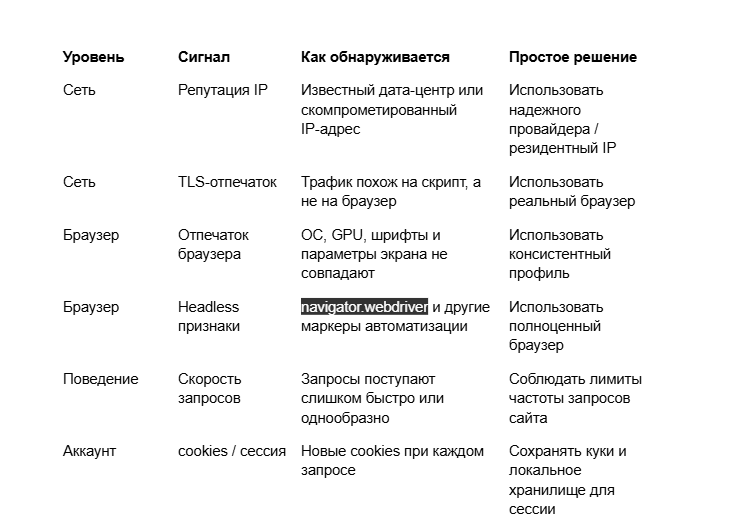
Методы, используемые системами управления ботами от Cloudflare, Akamai, DataDome и другими, по сути, одинаковы: каждому запросу присваивается оценка риска (risk score) на основе сигналов с четырёх уровней, и уже эта оценка определяет ответ сервера. Ваш парсер блокируют не за какой-то один сигнал, а за несколько таких несоответствий.
Комментарий Facebook Store: «Именно поэтому мы всегда собираем профиль целиком. Аккаунт, у которого с первого дня есть cookies, локальное хранилище и стабильный прокси, проходит проверки заметно легче, чем „одноразовый“ профиль. Для Facebook это особенно критично: резкая смена IP или часового пояса внутри сессии почти гарантированно вызывает проверку».
Почему чистый IP-адрес не всегда эффективен
В типичном сетапе, использующем резидентные прокси и скрипт на Python, скоринговая система увидит следующую картину. IP-адрес принадлежит условному городу Колумбус, штат Огайо, и исходит от обычного потребительского интернет-провайдера. Кажется, начало неплохое, но вот остальные детали не сходятся.
Браузер передаёт язык en-US, что логично для США, но JavaScript сообщает, что часовой пояс — UTC. А компьютер в Колумбусе в большинстве случаев использует Североамериканское восточное время.
Кроме того, в браузере параметр navigator.webdriver установлен в значение true, что может указывать на то, что он управляется скриптом. Это также усугубляется тем, что среда Docker не содержит шрифтов.
Есть и ещё одно расхождение. TLS-соединение выглядит так, будто оно инициировано библиотекой net/http языка Go, но User-Agent утверждает, что это браузер Chrome 151 на Windows 11.
Каждая из этих деталей сама по себе может и не быть большой проблемой. Однако в совокупности они представляют собой явное несоответствие. Это набор параметров, который вряд ли можно будет встретить на реальном компьютере в Колумбусе.
Мнение Facebook Store: «Прогрев нельзя имитировать точечно. Недостаточно выставить
navigator.webdriver = false
или подменить WebGL. Нужна согласованная среда: шрифты, разрешение экрана, рендерер, заголовки, TLS. Если хотя бы один слой выбивается, риск-скор растёт, и блокировка приходит даже на „идеальном“ IP».
Конечно, качественные прокси всё ещё необходимы, но на них история не заканчивается. Если на сетевом уровне используется пул реальных IP-адресов от настоящего провайдера, картина выглядит более естественной. И если после этого проблемы сохраняются, то вам следует сосредоточиться на деталях браузера, системы и самого соединения.
Детект headless-браузеров: что выдает Puppeteer и Playwright
Headless Chromium — это всё ещё реальный браузер, поэтому он успешно проходит множество базовых проверок TLS и HTTP/2. Но в самом браузере есть и другие зацепки, которые система обнаружения может отследить, чтобы понять, автоматизирован ли конкретный сеанс.
Вот несколько параметров, на которые они посмотрят в первую очередь:
В стандартном режиме автоматизации флаг navigator.webdriver будет установлен в значение true.
Массивы navigator.plugins и navigator.mimeTypes могут быть пустыми, тогда как в обычном десктопном Chrome там содержится информация о встроенных функциях.

WebGL может возвращать значения SwiftShader или стандартного рендерера Mesa. Это означает, что браузер использует программный рендеринг графики, а не физическую видеокарту.
Свойства window.outerWidth и outerHeight могут быть равны нулю, поскольку у headless-браузера нет нормального видимого окна.
Настройки уведомлений и разрешений браузера могут выдавать неоднозначные результаты.
Некоторые специфичные объекты Chrome, такие как chrome.runtime, могут вообще отсутствовать в браузере, который притворяется Chrome.
Существует множество признаков автоматизации, которые можно скрыть с помощью стелс-плагинов, но две проблемы могут оставаться нерешёнными.
Первая заключается в том, что автоматизация браузера способна изменять определённые паттерны его поведения, что может быть отслежено целевым сайтом.
Вторая проблема — это конфликтующие системные данные. Например, шрифты, часовой пояс или параметры TLS могут указывать на Linux-контейнер, в то время как WebGL будет говорить о наличии NVIDIA GPU.
Подобные противоречивые сигналы вызывают подозрения у системы защиты браузера.
Выявить такое несоответствие можно примерно за тридцать секунд. Сравните сигналы, которые собирает скрипт обнаружения, с данными, полученными при загрузке той же страницы через десктопный Chrome.
Если часовой пояс не совпадает с геолокацией вашего прокси или WebDriver возвращает true, проблема изначально была вовсе не в IP-адресе.
Настоящее требование — консистентность
Одно из решений, которое поможет избавиться от многих проблем с блокировками парсинга — это обеспечение полной согласованности всех деталей браузерного отпечатка.
Например, немецкий IP, использующий русский язык браузера и американский часовой пояс, выглядит подозрительно. Обычный компьютер (или сервер), где все параметры соответствуют друг другу, выглядит гораздо более логично.
В рамках сессии должен использоваться единый профиль, одна ОС, GPU, шрифты и параметры экрана, а также единый язык и часовой пояс. Кроме того, сессия должна сохранять собственные cookies и локальное хранилище данных, а также использовать один и тот же прокси на протяжении всего процесса.
Мнение Facebook Store: «Если профиль выглядит как живой пользователь из конкретного региона, он должен вести себя соответственно: заходить с той же локали, в те же часы, с той же скоростью запросов. Логика антибот-систем как раз и строится на поиске несоответствий между заявленным и фактическим».
Подобные настройки можно применять в таких инструментах, как антидетект-браузеры, где эти параметры привязываются к профилю и остаются консистентными от сессии к сессии.
Базовая концепция заключается в том, чтобы создавать единый цифровой профиль для каждой сессии и поддерживать его неизменным на протяжении всей работы.
Практический чек-лист перед тем, как обвинять прокси-провайдера в нечистоте пула
Большинство блокировок, с которыми сталкиваются большинство парсеров, вызваны первыми двумя пунктами.
Читайте тело ответа: Если на странице висит антибот-проверка, статус 200 — это всё равно блокировка. Важно проверять размер ответа и количество возвращаемых элементов страницы, а не полагаться только на код состояния.
Проверяйте часовой пояс: Убедитесь, что часовой пояс, отдаваемый через JavaScript, совпадает с локацией вашего прокси (учитывая переходы на летнее/зимнее время).
Проверяйте язык: Убедитесь, что заголовки Accept-Language и свойство navigator.languages соответствуют стране прокси-сервера.
Анализируйте TLS-отпечаток: Если ваш TLS-фингерпринт выдаёт программную библиотеку, простая подмена заголовков не поможет.
Ищите маркеры автоматизации: Проверяйте navigator.webdriver и другие специфические маркеры headless-браузеров.
Проверяйте WebGL: Убедитесь, что браузер отдаёт один из реальных аппаратных рендереров, а не программные SwiftShader или Mesa.
Проверяйте шрифты: Убедитесь, что системные шрифты установлены в вашем контейнере. Пустой список шрифтов — это явный индикатор headless-браузера.
Проверяйте HTTP-заголовки: Сравнивайте порядок их следования и регистр символов с дампами из реального браузера.
Совет Facebook Store: «По нашим наблюдениям, большинство обращений „прокси не работает“ после диагностики оказываются историями про профиль, а не про пул адресов. Поэтому рекомендуем тот же порядок действий: сначала тело ответа и часовой пояс, затем TLS-отпечаток и маркеры автоматизации, и только после этого писать провайдеру прокси».
Если не уверены, что в состоянии настроить подобный парсер, рекомендуем использовать стороннее решение в виде антидетект-браузера, который по умолчанию поддерживает всё вышеперечисленное и берёт сбор консистентного профиля на себя — вам останется лишь подставить рабочие и чистые прокси, и сбор данных продолжится.
Когда стоит перейти на вежливый парсинг
Всё вышесказанное предполагает, что вы собираете публичные данные, к которым у вас есть доступ. Прежде чем пытаться прокачать свой парсер, убедитесь, что вам вообще разрешено осуществлять автоматизированный сбор данных на данном ресурсе.
Соблюдайте правила и учитывайте директиву crawl-delay из файла robots.txt целевого сайта. Кроме того, поищите публичный API — многие ресурсы предоставляют те же самые данные через открытые API с использованием ключей и лимитами частоты запросов.
Если вы получаете ошибку 429, снизьте частоту ваших запросов. Также обязательно читайте пользовательские соглашения на сайтах, поскольку некоторые ресурсы прямо запрещают автоматизированный сбор информации.
Антибот-системы созданы для защиты веб-сайтов и их пользователей. Парсер, который следует правилам, отправляет запросы с разумной частотой и корректно идентифицирует себя, с меньшей вероятностью создаст проблемы, и его будет проще согласовать при проверках на соответствие политикам.
О партнёре. Экспертное мнение предоставлено магазином аккаунтов для Facebook Daddy Store — площадкой, специализирующейся на прогретых профилях и работе с консистентными цифровыми сессиями.


0 Comments